

**论文名称:**YOLOv8-Based XR Smart Glasses Mobility Assistive System for Aiding Outdoor Walking of Visually Impaired Individuals in South Korea
**研究方向:**智能眼镜、视障辅助、第一视角感知、移动端目标检测、辅助导航
**核心关键词:**XR Glasses、YOLOv8n、Unity Sentis、ONNX、Obstacle Detection、Risk Assessment、Voice Guidance
1. 前言:让智能眼镜为行走提供环境信息
走在人行道上,我们会不断观察周围环境:前方是否有人?路边的标牌有没有挡住去路?公交站位于哪个方向?斑马线距离自己还有多远?这些信息共同影响着下一步的行动。
对视障人士而言,白手杖、导盲犬和环境声音是重要的出行信息来源。随着可穿戴摄像头和移动端视觉模型的发展,智能眼镜也开始承担环境感知任务,将第一视角画面转化为语音和视觉提示。
本文介绍的论文面向韩国城市户外环境,设计了一套由 XR 智能眼镜、Android 手机和 YOLOv8n 模型组成的步行辅助系统。它围绕三个任务展开:识别道路与斑马线、发现公共交通设施,以及检测前方障碍物。
系统的核心思路是:
由眼镜采集前方画面,手机完成环境识别,再根据目标所在区域评估提示优先级,通过眼镜向用户提供方位和障碍信息。
这项研究把目标检测、区域风险评估和多通道反馈连接到同一个移动应用中。理解它,可以沿着四个环节展开:采集环境、识别目标、组织风险、传达信息。
2. 研究背景:视障出行需要哪些信息?
2.1 从路线导航到局部环境感知
日常出行包含不同尺度的判断。一方面,用户需要知道从起点到终点应该经过哪些路段;另一方面,也需要随时了解眼前的道路和障碍情况。
| 信息层次 | 典型问题 | 对应能力 |
|---|---|---|
| 路线信息 | 从车站到学校应该怎么走? | 地图、定位、路线规划 |
| 设施信息 | 公交站或地铁出入口在哪里? | 交通设施识别、相对方位判断 |
| 道路信息 | 前方有哪些道路区域和斑马线? | 路径目标识别 |
| 障碍信息 | 前方是否有人、车辆或隔离柱? | 障碍物检测、风险提示 |
论文将重点放在用户前方的环境信息上,希望通过第一视角视觉,为白手杖和导盲犬提供补充。眼镜贴近用户视线,也便于在保持双手可用的同时采集画面和接收提示。
2.2 用户需求调查
作者在首尔盲校对 15 名教师和视障学生开展了问卷调查,了解他们的出行工具、风险感受和对辅助系统的看法。调查采用五分量表,风险相关分数越高,表示受访者越关注该因素。
| 调查内容 | 结果 |
|---|---|
| 首选出行辅助工具 | 白手杖 11 人,导盲犬 4 人 |
| 风险感知较高的对象 | 突出物 4.8、台阶 4.6、坑洞 4.5 |
| 障碍风险影响因素 | 障碍存在 5.0、位置 4.8、移动速度 4.2 |
| 系统相关主观评价 | 功能 4.2、易用性 3.8、语音质量 4.0 |
这些反馈帮助作者确定了两个设计重点。
第一,提示需要包含位置。用户除了知道“前面有物体”,还需要知道物体处于左侧、中央还是右侧,以及是否接近自己的行走区域。
第二,提示需要有优先级。频繁播报所有识别结果容易分散注意力,系统应优先传递与当前行走关系更密切的信息。
因此,论文在目标检测之后加入了区域划分和风险加权,让环境识别结果进一步服务于行走提示。
3. 系统整体架构:眼镜感知,手机计算,眼镜反馈
3.1 硬件组成
系统采用 Xreal Light 智能眼镜和 Android 手机,两者通过 USB-C 连接。手机为眼镜供电,同时运行视觉推理和提示管理程序。
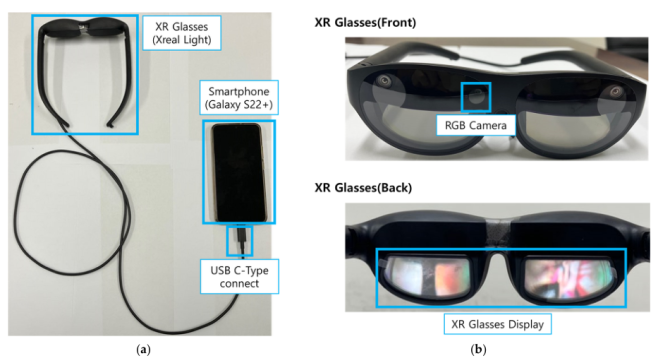
*图 1:系统硬件组成,摘自原文图 6,第 9 页。
| 组件 | 主要职责 |
|---|---|
| RGB 摄像头 | 采集用户前方的第一视角图像 |
| Android 手机 | 运行应用、模型推理、结果处理和提示管理 |
| USB-C 连接 | 连接眼镜与手机,并为眼镜供电 |
| 眼镜显示屏 | 显示目标标记和风险信息 |
| 眼镜扬声器 | 播放方向提示和障碍提醒 |
这种配置将手机作为计算平台,利用现有移动设备承载模型和应用逻辑。眼镜则承担采集与反馈,使信息始终围绕用户当前看到的环境展开。
3.2 软件处理流程
论文通过 Unity 开发移动应用,整体流程如下:
前方图像 → 三个 YOLOv8n 模型 → 目标位置与区域分析 → 风险评估 → 视觉和语音反馈。
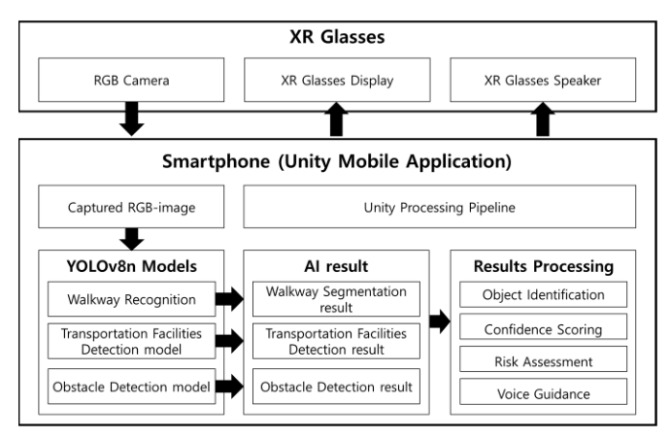
*图 2:系统软件流程,摘自原文图 7,第 9 页。
可以把它理解为三个相互衔接的处理层次:
| 层次 | 输入 | 处理任务 | 输出 |
|---|---|---|---|
| 环境感知 | 摄像头图像 | 识别路径、设施和障碍物 | 类别、检测框、置信度 |
| 信息组织 | 三类模型结果 | 判断区域、计算权重、组织风险 | 目标方位和提示优先级 |
| 用户反馈 | 整合后的环境信息 | 生成显示标记和语音提示 | 用户可接收的行走信息 |
这个流程把视觉模型的输出转化为更容易理解的信息。例如,模型提供“目标类别为标牌,位于某个检测框”,后续模块再将其组织为前方某个方向的障碍提示。
3.3 视觉与语音协同
视觉反馈通过眼镜显示屏标记目标位置和风险信息,帮助能够利用残余视力的用户观察环境。语音反馈则用于表达方向变化和潜在危险。
两种反馈方式可以围绕同一个识别结果展开:显示屏标出目标所在位置,语音强调其方向和重要程度。这样,环境感知、位置表达和用户提示能够在同一设备上衔接。
4. 三个 YOLOv8n 模型:分别识别路径、设施和障碍
4.1 为什么采用 YOLOv8n?
手机需要同时处理视频采集、模型推理、图像显示和语音提示,计算资源与电量都需要合理分配。论文选择 YOLOv8 的 nano 版本,利用轻量模型完成多个环境识别任务。
YOLOv8n 在系统中输出目标类别、位置和置信度。这些结果既能用于画面标记,也能作为后续区域分析和风险计算的输入。
4.2 路径识别模型
路径模型主要识别 Road(道路) 和 Crosswalk(斑马线)。它提供前方画面的道路属性,帮助系统组织与行走区域有关的信息。
道路和斑马线通常覆盖较大范围,系统会进一步分析检测结果与九宫格区域的重叠关系,确定目标主要位于哪个方向。
4.3 公共交通设施识别模型
公共交通设施模型识别两类目标:
- 公交站;
- 地铁出入口。
这类信息与出行目的直接相关。例如,用户接近公交站时,模型可以发现站点目标,后续模块再根据其图像位置组织方位提示。
作者针对实验地区的公交站和地铁出入口进行了实地拍摄,使训练数据包含当地设施的外观和布局。
4.4 障碍物识别模型
障碍物模型覆盖九类常见街景目标:
| 类别 | 英文名称 | 对行走环境的意义 |
|---|---|---|
| 汽车 | Car | 车辆相关环境信息 |
| 卡车 | Truck | 大型车辆位置 |
| 公交车 | Bus | 公交车辆位置 |
| 行人 | Person | 前方人员分布 |
| 移动标牌 | Movable signage | 路边或通道中的临时物体 |
| 摩托车 | Motorcycle | 两轮机动车位置 |
| 交通灯 | Traffic light | 交通设施目标位置 |
| 自行车 | Bicycle | 骑行车辆或停放物体位置 |
| 隔离柱 | Bollard | 近地面的通道分隔物 |
模型输出检测框及其置信度,应用根据置信度筛选识别结果。论文也提供了通过置信度调整障碍检测敏感度的方式。
4.5 三类信息如何配合?
以接近公交站的场景为例,路径模型提供道路与斑马线的位置,设施模型定位公交站,障碍物模型识别通道附近的行人、车辆和标牌。后续模块将这些结果整合,形成关于“道路在哪里、设施在哪里、哪些目标需要注意”的环境信息。
三个模型各自承担明确任务,也为应用安排执行顺序和管理输出提供了清晰的组织方式。
5. 数据集与训练:从街景图像学习目标特征
5.1 数据来源与规模
道路和障碍物数据主要来自韩国 AI Hub 的 Walking on the Sidewalk 数据集,作者还在实验地区采集了补充图像。交通设施数据包含对公交站和地铁出入口的实地拍摄。
论文的数据分布表给出了以下图像数量:
| 任务 | 训练图像 | 验证图像 | 对应表格 |
|---|---|---|---|
| 路径识别 | 11,071 | 3,163 | 表 2 |
| 交通设施识别 | 7,144 | 2,032 | 表 5 |
| 障碍物识别 | 296,949 | 82,826 | 表 8 |
路径训练集包含 7,231 张原始照片,并通过增强扩展到表中规模。交通设施任务也使用了增强数据;障碍物任务则利用较大规模的图像进行训练。
图像数与目标标签数分别描述不同层面的数据规模。一张街景照片中可以同时出现多辆车、多个行人和多个隔离柱,因此一张图像通常可以对应多个目标标注。
5.2 数据增强
路径识别采用的增强方式包括旋转、噪声和灰度变换。
| 增强方式 | 对图像的改变 | 训练作用 |
|---|---|---|
| 旋转 | 改变目标在图像中的方向 | 增加视角变化 |
| 噪声 | 加入像素扰动 | 增加成像变化 |
| 灰度变换 | 减少颜色信息 | 增加对轮廓和结构特征的利用 |
这些变换在现有照片基础上扩展了图像表现形式,使模型在训练中接触更多样的输入。
5.3 训练参数
三类模型采用相同的主要训练配置:
| 参数 | 数值 | 含义 |
|---|---|---|
| 输入分辨率 | 640 × 640 | 模型输入图像的空间尺寸 |
| Epoch | 100 | 训练迭代轮数 |
| Batch size | 16 | 每批处理的图像数 |
| Learning rate | 0.01 | 参数更新的学习率 |
| Momentum | 0.937 | 优化过程的动量参数 |
| Weight decay | 0.0005 | 权重衰减参数 |
训练完成后,模型进入格式转换和移动应用集成流程。训练阶段得到目标识别能力,部署阶段则将这种能力接入眼镜采集、手机计算和提示反馈。
6. 九宫格风险评估:把图像位置变成提示优先级
6.1 为什么划分九个区域?
目标检测给出的是图像坐标。为了更方便地描述位置,论文将用户前方画面划分为九个区域,分别编号为 0—8。
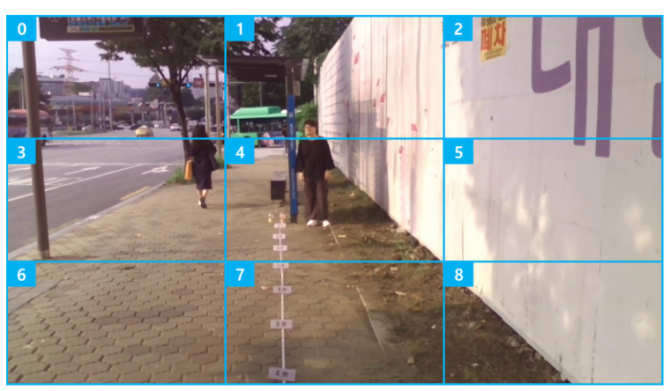
*图 3:九宫格区域划分,摘自原文图 10,第 12 页。
| 画面位置 | 左侧 | 中央 | 右侧 |
|---|---|---|---|
| 上排 | 区域 0 | 区域 1 | 区域 2 |
| 中排 | 区域 3 | 区域 4 | 区域 5 |
| 下排 | 区域 6 | 区域 7 | 区域 8 |
论文将上排、中排和下排分别用于表达较远、中距离和较近区域,并通过三列区分左右方向。这种划分以画面位置提供粗略的远近与方位线索,便于将检测结果转成方向提示。
6.2 区域权重如何组织?
区域权重体现两个设计原则:靠近用户的区域获得较高权重,位于前进方向中央的区域获得更高关注。
论文采用以下形式描述区域权重:
<math><semantics><mrow><mi>W</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo><mo>=</mo><mi>B</mi><mo>(</mo><mi>i</mi><mo>)</mo><mo>×</mo><mi>D</mi><mo>(</mo><mi>j</mi><mo>)</mo><mo>×</mo><mi>L</mi><mo>(</mo><mi>i</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">W(i,j)=B(i)\times D(j)\times L(i) </annotation></semantics></math>W(i,j)=B(i)×D(j)×L(i)
其中,<math><semantics><mrow><mi>B</mi><mo>(</mo><mi>i</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">B(i)</annotation></semantics></math>B(i) 表示基础风险权重,<math><semantics><mrow><mi>D</mi><mo>(</mo><mi>j</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">D(j)</annotation></semantics></math>D(j) 表示左右位置权重,<math><semantics><mrow><mi>L</mi><mo>(</mo><mi>i</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">L(i)</annotation></semantics></math>L(i) 表示距离相关调节项。通过这些因素,系统将区域位置转换为提示排序的依据。
论文列出的九宫格权重为:
| 画面位置 | 左侧 | 中央 | 右侧 |
|---|---|---|---|
| 上排,较远 | 0.16 | 0.20 | 0.16 |
| 中排 | 0.42 | 0.525 | 0.42 |
| 下排,较近 | 0.80 | 1.00 | 0.80 |
正前方近处的区域 7 权重为 1.00,左右近处区域为 0.80;远处两侧区域为 0.16。由此,系统可以优先组织与用户前进方向关系更密切的目标信息。
6.3 将障碍特征加入风险评分
在区域权重基础上,论文进一步引入障碍物风险因子:
<math><semantics><mrow><mi>R</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo><mo>=</mo><mi>W</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo><mo>×</mo><mi>O</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">R(i,j)=W(i,j)\times O(i,j) </annotation></semantics></math>R(i,j)=W(i,j)×O(i,j)
其中:
- <math><semantics><mrow><mi>R</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">R(i,j)</annotation></semantics></math>R(i,j):区域的最终风险评分;
- <math><semantics><mrow><mi>W</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">W(i,j)</annotation></semantics></math>W(i,j):区域权重;
- <math><semantics><mrow><mi>O</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">O(i,j)</annotation></semantics></math>O(i,j):与障碍物特征有关的风险因子。
这一表达将空间位置与目标特征结合起来。论文讨论了大小、运动等特征作为附加因素的思路,让风险组织能够同时考虑目标在哪里以及目标本身的特点。
6.4 用一个例子理解区域加权
下面用一个简化示例说明计算过程。假设两个目标的附加风险因子均取 1:一个目标位于区域 7,另一个位于区域 2。
<math><semantics><mrow><msub><mi>R</mi><mn>7</mn></msub><mo>=</mo><mn>1</mn><mi mathvariant="normal">.</mi><mn>0</mn><mn>0</mn><mo>×</mo><mn>1</mn><mo>=</mo><mn>1</mn><mi mathvariant="normal">.</mi><mn>0</mn><mn>0</mn></mrow><annotation encoding="application/x-tex">R_7=1.00\times1=1.00 </annotation></semantics></math>R7=1.00×1=1.00
<math><semantics><mrow><msub><mi>R</mi><mn>2</mn></msub><mo>=</mo><mn>0</mn><mi mathvariant="normal">.</mi><mn>1</mn><mn>6</mn><mo>×</mo><mn>1</mn><mo>=</mo><mn>0</mn><mi mathvariant="normal">.</mi><mn>1</mn><mn>6</mn></mrow><annotation encoding="application/x-tex">R_2=0.16\times1=0.16 </annotation></semantics></math>R2=0.16×1=0.16
按照区域权重,位于区域 7 的目标会获得更高的提示优先级。这里的数值用于组织提醒顺序;实际应用还会结合障碍物特征处理结果。
这个示例也说明了九宫格的作用:将连续的图像坐标转成有限的方位区域,再通过权重组织用户需要优先关注的信息。
7. 方向引导:从目标位置到语音表达
7.1 根据区域覆盖确定主要方位
对于道路、斑马线等目标,系统分析检测框与各区域的重叠面积,选择覆盖比例最高的区域,作为目标主要方位:
<math><semantics><mrow><mi>D</mi><mo>(</mo><mi>o</mi><mo>)</mo><mo>=</mo><mi>arg</mi><msub><mi>max</mi><mrow><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo></mrow></msub><mfrac><mrow><mi>A</mi><mo>(</mo><mi>o</mi><mo separator="true">,</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo></mrow><mrow><mi>A</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo></mrow></mfrac></mrow><annotation encoding="application/x-tex">D(o)=\arg\max_{(i,j)}\frac{A(o,i,j)}{A(i,j)} </annotation></semantics></math>D(o)=arg(i,j)maxA(i,j)A(o,i,j)
其中,<math><semantics><mrow><mi>A</mi><mo>(</mo><mi>o</mi><mo separator="true">,</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">A(o,i,j)</annotation></semantics></math>A(o,i,j) 为目标框在区域中的覆盖面积,<math><semantics><mrow><mi>A</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">A(i,j)</annotation></semantics></math>A(i,j) 为该区域的总面积,<math><semantics><mrow><mi>D</mi><mo>(</mo><mi>o</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">D(o)</annotation></semantics></math>D(o) 为选出的目标方位。
可以将这个过程理解为三个步骤:
- 将目标框映射到九宫格画面。
- 计算它与各格的重叠比例。
- 选择占比最高的一格,组织相应方向信息。
例如,在三个等面积区域中,某目标的覆盖比例分别为 0.1、0.3 和 0.6,则覆盖比例为 0.6 的区域会成为它的主要方位。这个说明性示例体现了检测框向区域信息的转换过程。
7.2 加入对象的引导系数
论文还将区域权重与对象安全系数结合,用于行走方向的提示评分:
<math><semantics><mrow><msub><mi>W</mi><mi>g</mi></msub><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo><mo>=</mo><mi>W</mi><mo>(</mo><mi>i</mi><mo separator="true">,</mo><mi>j</mi><mo>)</mo><mo>×</mo><mi>S</mi><mo>(</mo><mi>o</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">W_g(i,j)=W(i,j)\times S(o) </annotation></semantics></math>Wg(i,j)=W(i,j)×S(o)
<math><semantics><mrow><mi>S</mi><mo>(</mo><mi>o</mi><mo>)</mo></mrow><annotation encoding="application/x-tex">S(o)</annotation></semantics></math>S(o) 表示对象安全系数。原文以斑马线取 1.0、普通道路取 0.8 为示例,说明不同对象属性可以参与引导信息的组织。
区域权重回答“这个方向与用户的位置关系如何”,对象系数则表达“这个对象在引导策略中如何参与评分”。两者共同为提示模块提供输入。
7.3 用用户容易理解的方式表达
完成方位判断后,系统通过语音和视觉传达结果。论文举出了钟点方位的表达方式,例如用“两点钟方向”描述目标所在方位。
这种表达把图像坐标转换成用户熟悉的空间语言。视觉标记同时保留目标在画面中的位置,帮助使用残余视力的用户将提示与实际环境联系起来。
8. 移动端部署:模型转换、帧管理与错峰执行
8.1 从训练模型到 Unity 应用
作者使用 Unity 2022.3.11f1 开发移动应用,模型部署流程为:
YOLOv8n 训练模型 → ONNX → Unity Sentis → Android 应用。
模型先导出为 ONNX,再转换为 Unity Sentis 可使用的形式。部署时固定输入张量形状为 (1, 3, 640, 640),采用 Float32 精度。
| 维度 | 数值 | 对应含义 |
|---|---|---|
| Batch | 1 | 每次处理一张图像 |
| Channel | 3 | 三个颜色通道 |
| Height | 640 | 图像高度 |
| Width | 640 | 图像宽度 |
统一输入形状让应用能够按照固定流程准备图像、执行推理并接收输出,便于将三个模型接入同一处理框架。
8.2 图像采集与缓存
摄像头以 60 FPS 采集图像,相邻帧间隔约为 16.7 ms。应用通过循环缓冲保存最近的帧,并丢弃过时帧,以管理连续采集产生的数据。
循环缓冲的作用是让图像输入保持更新,同时控制缓存规模。后续模型按照各自的执行时机读取图像,采集与推理通过应用调度衔接。
8.3 三个模型如何错峰执行?
论文在一个 60 帧周期中分配三个模型的执行位置:
| 周期内位置 | 对应任务 | 按 60 FPS 换算的时间位置 |
|---|---|---|
| 第 0 帧 | 路径识别 | 约 0 ms |
| 第 20 帧 | 交通设施识别 | 约 333 ms |
| 第 40 帧 | 障碍物识别 | 约 667 ms |
| 每 60 帧 | 整合最近结果并组织反馈 | 约 1 s 的周期边界 |
这里包含两种频率:摄像头持续以 60 FPS 采集,模型按周期中的指定位置执行。按照这一调度设计,每个模型约每秒执行一次,应用再整合各任务的最近结果。
错峰执行将多个任务分布到不同时间位置,便于控制瞬时计算负载,并协调内存与输出管理。
8.4 应用层优化
论文还介绍了以下资源管理措施:
| 优化措施 | 主要作用 |
|---|---|
| Texture2D 对象池 | 复用图像对象,减少反复创建 |
| 静态内存分配优化 | 改善运行过程中的内存管理 |
| 跳帧 | 按处理能力选择执行时机 |
| 动态分辨率调整 | 根据运行负载调整输入处理 |
| CPU/GPU 负载平衡 | 协调应用中的计算任务 |
这些措施与轻量模型、周期调度共同构成了移动端运行方案,使图像输入、模型处理和反馈输出能够在同一个应用中持续进行。
9. 实验结果:识别表现与移动端运行性能
9.1 检测指标怎样理解?
论文使用 Precision、Recall、F1-score 和 AP 评价目标检测表现。
| 指标 | 含义 |
|---|---|
| Precision | 检测结果中正确目标所占的比例 |
| Recall | 实际目标被模型检出的比例 |
| F1-score | Precision 与 Recall 的调和平均 |
| AP@0.5 | 在 IoU 阈值 0.5 下计算的平均精度 |
| AP@[0.5:0.95] | 对多个 IoU 阈值的 AP 进行平均 |
IoU 描述预测框与真实标注框的重叠程度。阈值越高,对定位的要求越严格。通过两种 AP 指标,可以分别观察目标检出与更严格定位要求下的表现。
9.2 路径与公共交通设施识别
论文表 4 和表 7 给出的结果如下:
| 任务与类别 | Precision | Recall | F1-score | AP@0.5 | AP@[0.5:0.95] |
|---|---|---|---|---|---|
| 路径:斑马线 | 0.749 | 0.655 | 0.698 | 0.689 | 0.550 |
| 路径:道路 | 0.866 | 0.820 | 0.842 | 0.885 | 0.767 |
| 设施:公交站 | 0.749 | 0.655 | 0.698 | 0.689 | 0.550 |
| 设施:地铁出入口 | 0.866 | 0.820 | 0.842 | 0.885 | 0.767 |
路径识别中,道路的 AP@0.5 为 0.885,斑马线为 0.689;交通设施识别中,地铁出入口的 AP@0.5 为 0.885,公交站为 0.689。这些分类别指标展示了模型在各自评测任务中的识别表现,也为后续补充训练数据和优化模型提供了方向。
9.3 九类障碍物识别
障碍物检测结果见原文表 10:
| 类别 | Precision | Recall | F1-score | AP@0.5 | AP@[0.5:0.95] |
|---|---|---|---|---|---|
| 汽车 | 0.901 | 0.914 | 0.907 | 0.966 | 0.815 |
| 卡车 | 0.893 | 0.802 | 0.845 | 0.903 | 0.714 |
| 公交车 | 0.867 | 0.807 | 0.836 | 0.896 | 0.720 |
| 行人 | 0.899 | 0.846 | 0.871 | 0.927 | 0.672 |
| 移动标牌 | 0.835 | 0.738 | 0.783 | 0.842 | 0.647 |
| 摩托车 | 0.929 | 0.848 | 0.886 | 0.937 | 0.644 |
| 交通灯 | 0.835 | 0.759 | 0.795 | 0.851 | 0.565 |
| 自行车 | 0.862 | 0.812 | 0.836 | 0.893 | 0.622 |
| 隔离柱 | 0.855 | 0.750 | 0.799 | 0.843 | 0.560 |
汽车的 AP@0.5 为 0.966,行人为 0.927,摩托车为 0.937。九类目标的 AP@0.5 分布在 0.842—0.966 之间,覆盖了车辆、人员和多种街道路侧物体。
在更严格的 AP@[0.5:0.95] 指标下,汽车为 0.815,隔离柱为 0.560。结合两项 AP,可以同时观察不同类别的目标识别与定位表现。
9.4 推理耗时与内存占用
论文在手机上测量了各模型及整合处理的运行性能:
| 模型 | 平均推理或处理时间 | 测得的模型运行内存 |
|---|---|---|
| 路径识别 | 150 ms | 29.7 MB |
| 交通设施识别 | 146 ms | 29.3 MB |
| 障碍物识别 | 155 ms | 30 MB |
| 三模型整合 | 583 ms | 80 MB |
数据来源:原文表 11。整合处理时间不包含语音引导耗时。
三个单模型的平均耗时接近,约为 150 ms;三模型整合处理平均为 583 ms。结合内存测量,这组数据展示了在手机上同时组织多类环境感知任务的资源开销。
在实际应用流程中,模型推理完成后还会进行结果组织和语音输出。论文采用周期执行与统一反馈管理,将这些环节连接到持续运行的移动应用中。
10. 户外测试:在城市步行路线中运行系统
10.1 实验路线与参与者
作者选择韩国福井站(Bokjeong Station)到嘉泉大学的一段路线进行测试,全长约 3.3 km。沿途包含人行道、道路、自行车道、交通设施以及不同类型的障碍物。
| 项目 | 实验安排 |
|---|---|
| 路线长度 | 约 3.3 km |
| 起点与终点 | 福井站至嘉泉大学 |
| 参与者 | 5 名研究人员 |
| 单次实验时间 | 约 1—2 小时 |
| 重复安排 | 原文描述为每位参与者至少重复 3—4 次 |
| 设备 | XR 眼镜与 Android 手机系统 |
测试围绕沿途目标识别、行走方向提示和障碍提醒展开,观察多个模块在连续步行过程中的配合情况。
10.2 测试中的反馈方式
系统通过两种主要方式提供信息:
- 在眼镜显示屏上标记识别到的路径、设施和障碍物;
- 通过语音传达方向变化和潜在危险。
作者报告,系统在测试路线中能够持续识别环境,并通过整合三类模型结果提供提示。与静态图片评测相比,连续户外运行把相机输入、模型执行、区域分析和反馈管理放到了同一个使用过程中。
10.3 与公共交通和地图服务结合
论文还讨论了与韩国公共交通及地图服务衔接的方向。设施识别可以提供公交站、地铁出入口的位置线索,地图服务则用于组织起终点之间的路线。
作者将与 Naver、Kakao、SK 等地图应用的路线联动列为持续开展的研究工作,希望进一步连接局部环境信息与整体出行路线。
11. 实际使用中的挑战与后续方向
11.1 低光环境下的识别
作者指出,训练数据主要来自白天,夜间和照明不足环境会影响识别稳定性。后续计划包括扩展不同光照条件的数据、开发低光模型,以及根据环境照明选择合适的模型。
这一方向直接关系到使用时间范围:系统需要适应日间、傍晚和夜间等不同条件,让环境识别更好地覆盖日常出行情境。
11.2 强光下的显示效果
强烈阳光会影响眼镜显示标记的可见性。论文提出改善显示对比度、自适应亮度和目标高亮方式,使用户在不同室外光照下更容易接收视觉信息。
模型感知与显示输出分别位于处理流程的两端,两者都需要适应光照变化,才能将信息顺畅地传递给用户。
11.3 佩戴舒适度与续航
系统由手机供电,作者报告连续运行约两小时。长时间使用还涉及眼镜重量、佩戴方式及与白手杖等工具配合的问题。
后续硬件改进围绕轻量化、人体工学设计和能效展开,使设备更适合持续步行和日常佩戴。
11.4 语音提示与信息负担
作者在测试中发现,频繁危险提示可能影响体验。后续计划包括提示优先级管理、上下文相关提醒、可定制语音和信息过滤。
这类优化让系统更关注提示的时机和内容:用户需要及时知道与当前行走有关的信息,同时也要保留听取周围环境声音的注意力。
11.5 扩展视障用户实验
作者计划进一步邀请全盲和低视力用户参与测试,收集使用反馈,并在不同环境和步行情境下评估系统。
这将帮助研究者了解不同视力状况、出行习惯和反馈偏好对系统使用的影响,也为视觉界面、语音交互和设备配置提供更直接的改进依据。
12. 技术思考:把感知结果组织成可用的信息
这项研究提供了一个清晰的辅助出行系统实现路径:第一视角输入、轻量环境感知、区域风险组织和多通道反馈。
从技术设计来看,有三个环节值得关注。
12.1 多类感知共同描述行走环境
道路、交通设施和障碍物分别对应用户出行中的不同信息需求。将三类任务结合,能让系统围绕“在哪里走、要去哪里、需要注意什么”组织环境信息。
这一任务划分也便于理解各模块的角色。路径识别提供道路属性,设施识别关联出行目标,障碍检测补充当前行走区域的信息。
12.2 用空间区域衔接视觉和语言
九宫格将目标位置转换为有限的相对方位,使图像坐标能够进一步转成用户容易理解的方向提示。区域权重又让不同位置参与信息排序,从而将检测与反馈连接起来。
这个中间表示较为直观:模型输出目标,区域规则组织位置,提示模块表达重点。对面向用户的视觉应用而言,这种衔接方式具有参考价值。
12.3 将模型与应用流程一起设计
手机端的计算任务包含图像采集、缓存、推理、显示和语音管理。论文通过轻量模型、错峰执行和资源复用,把这些任务组织到一个持续运行的系统中。
因此,辅助出行设备的设计需要同时考虑识别能力、计算开销和用户反馈。模型提供环境感知基础,应用层则决定这些信息何时被处理、怎样被呈现。
这篇论文展示了 XR 眼镜与移动视觉结合的一种实践:以用户的第一视角为输入,用结构化的区域规则组织环境,再通过语音和显示提供行走信息。围绕光照适应、佩戴体验、提示策略与用户研究继续完善,将有助于推动这类系统向日常使用发展。